

专栏计算与加速
美团开源LongCat-2.5,国产算力推理优化随权重开放
据IT之家11月9日报道,美团正式开源LongCat-2.5,模型权重采用MIT协议。这个1.6万亿参数的原生多模态模型面向长程智能体任务,并公开了国产加速器上的低比特推理方案及昇腾集群部署样例,为企业自行部署提供了更具体的工程路径。
11月2日,美团发布面向长程智能体任务的LongCat-2.5,随后通过网页和API提供服务;到11月9日,美团宣布模型正式开源。据IT之家报道,此次开放支持商用推理部署与二次训练,无需额外授权。美团在Hugging Face发布的模型说明确认,权重采用MIT协议。开发者因此可以在自己的基础设施上部署模型,并针对业务继续训练。模型覆盖复杂代码库开发、完整项目构建、视觉编程和3D任务,随模型公开的国产算力推理方案,则把开放范围延伸到了实际部署环节。
国产集群已有训练基线
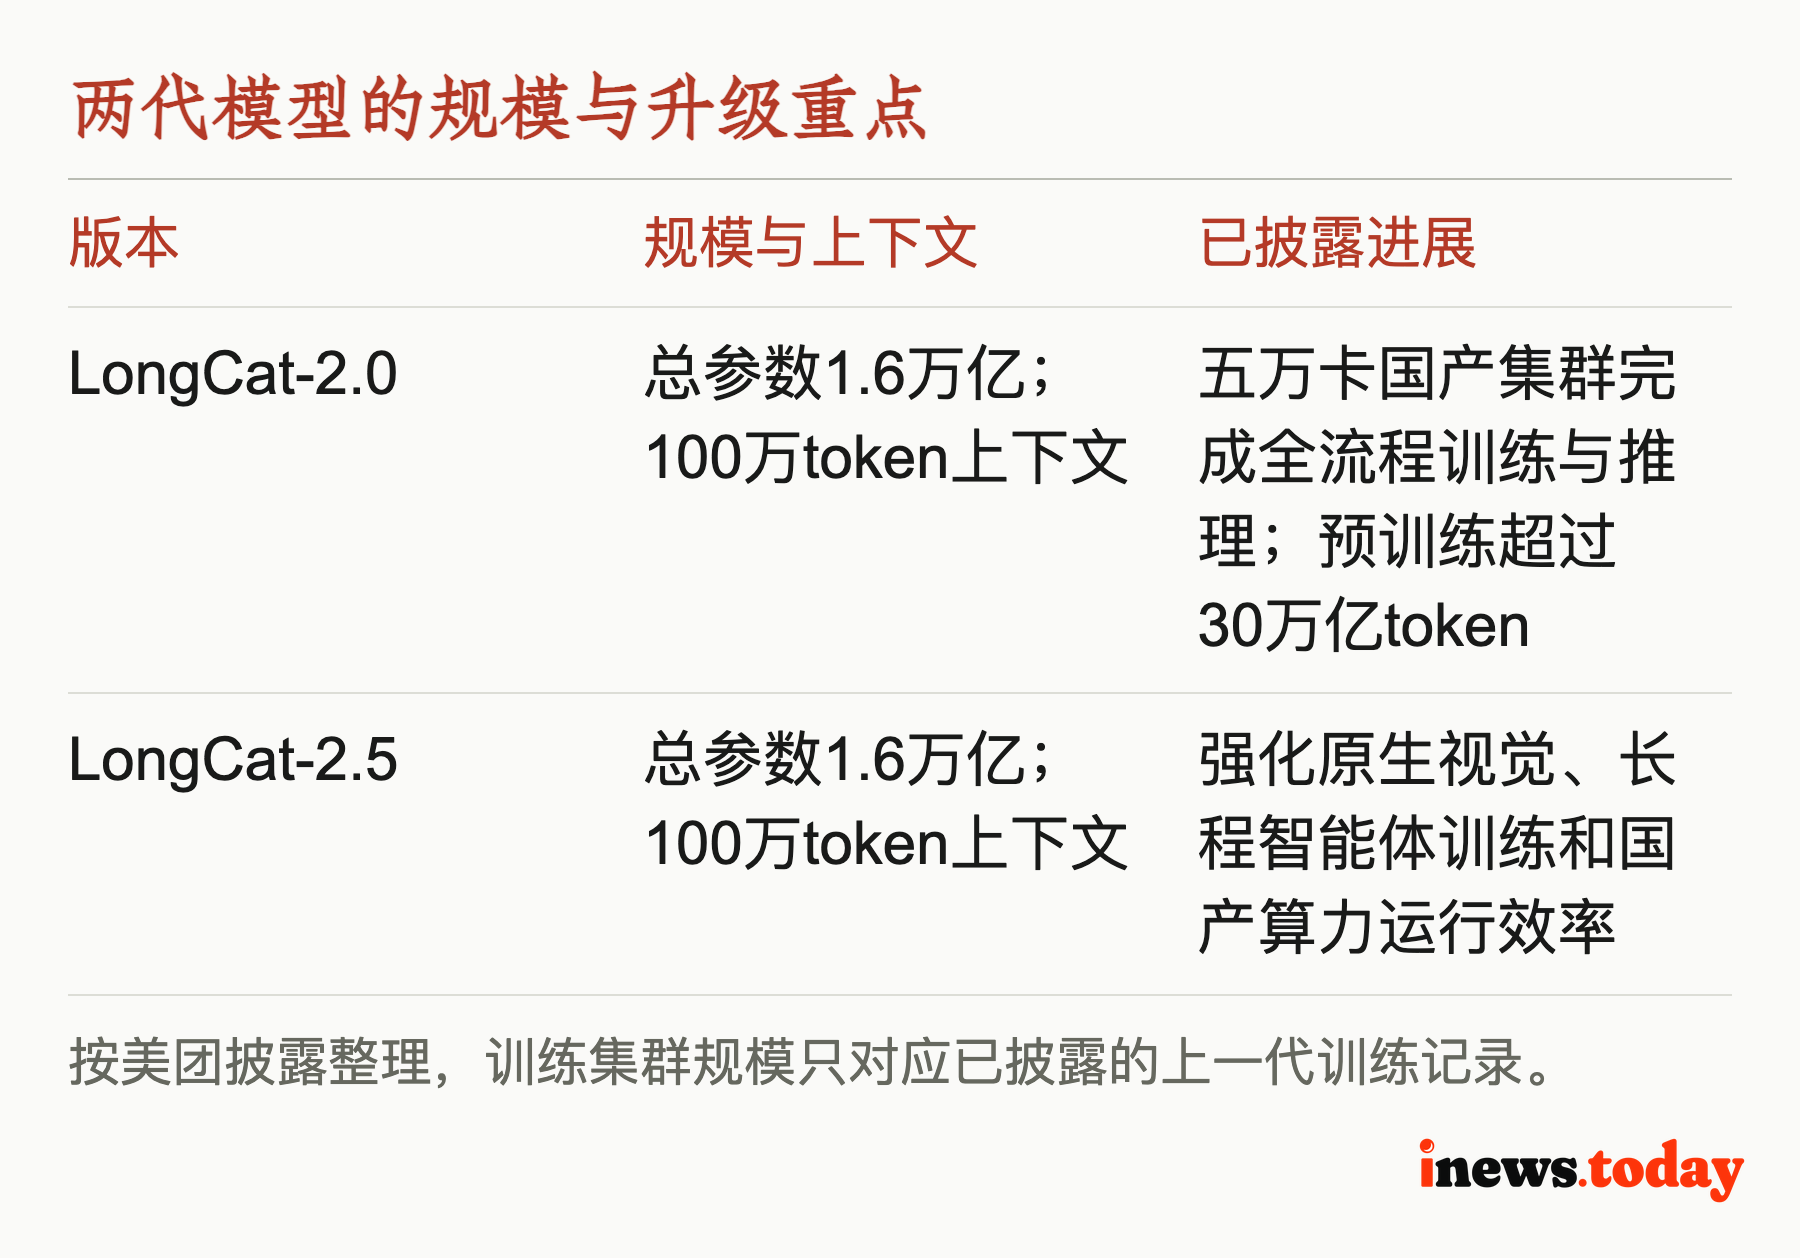
国产算力适配有一条已经披露的训练基线。美团技术团队在6月30日发布LongCat-2.0时披露,该模型在五万卡国产算力集群上完成全流程训练与推理,预训练数据超过30万亿token,总参数1.6万亿,原生支持100万token上下文。LongCat-2.5仍是1.6万亿总参数、每token激活约480亿参数,支持100万token上下文,升级重点落在原生视觉理解、长程智能体训练和国产算力上的运行效率。这使本次发布的判断重点从参数规模,转向同等规模模型如何完成更复杂的任务、如何被部署。
训练系统首先要解决模型能否装下、跨卡通信如何安排。针对国产算力单卡显存不足80GB的约束,美团把参数、专家和上下文的并行分组与超节点拓扑对齐,让参数汇集、专家token交换和注意力缓存汇集尽量在节点内的高带宽互联域完成。参数留在节点内分片,优化器状态等训练数据进一步跨域分片;面对专家负载不均,系统只在达到预设阈值时复制专家,控制额外通信和显存压力。这里的适配涉及模型的数据布局与任务调度,需要推理框架和底层算子共同配合。
低比特贯穿通信与计算
推理阶段,低比特优化直接作用于数据搬运和矩阵计算。LongCat-2.5采用W4A4方案,将专家权重与激活同时量化至4bit,通过国产加速器的原生INT4矩阵乘法单元计算。美团在专家输入端设置共享变换,使量化发生在token复制和分发之前,同一份INT4表示可以贯穿专家通信与计算。变换、尺度计算、量化和打包再融合进专用算子,减少中间转换。对于需要跨卡分发token的混合专家模型,这条数据路径与计算精度本身同样影响运行效率。
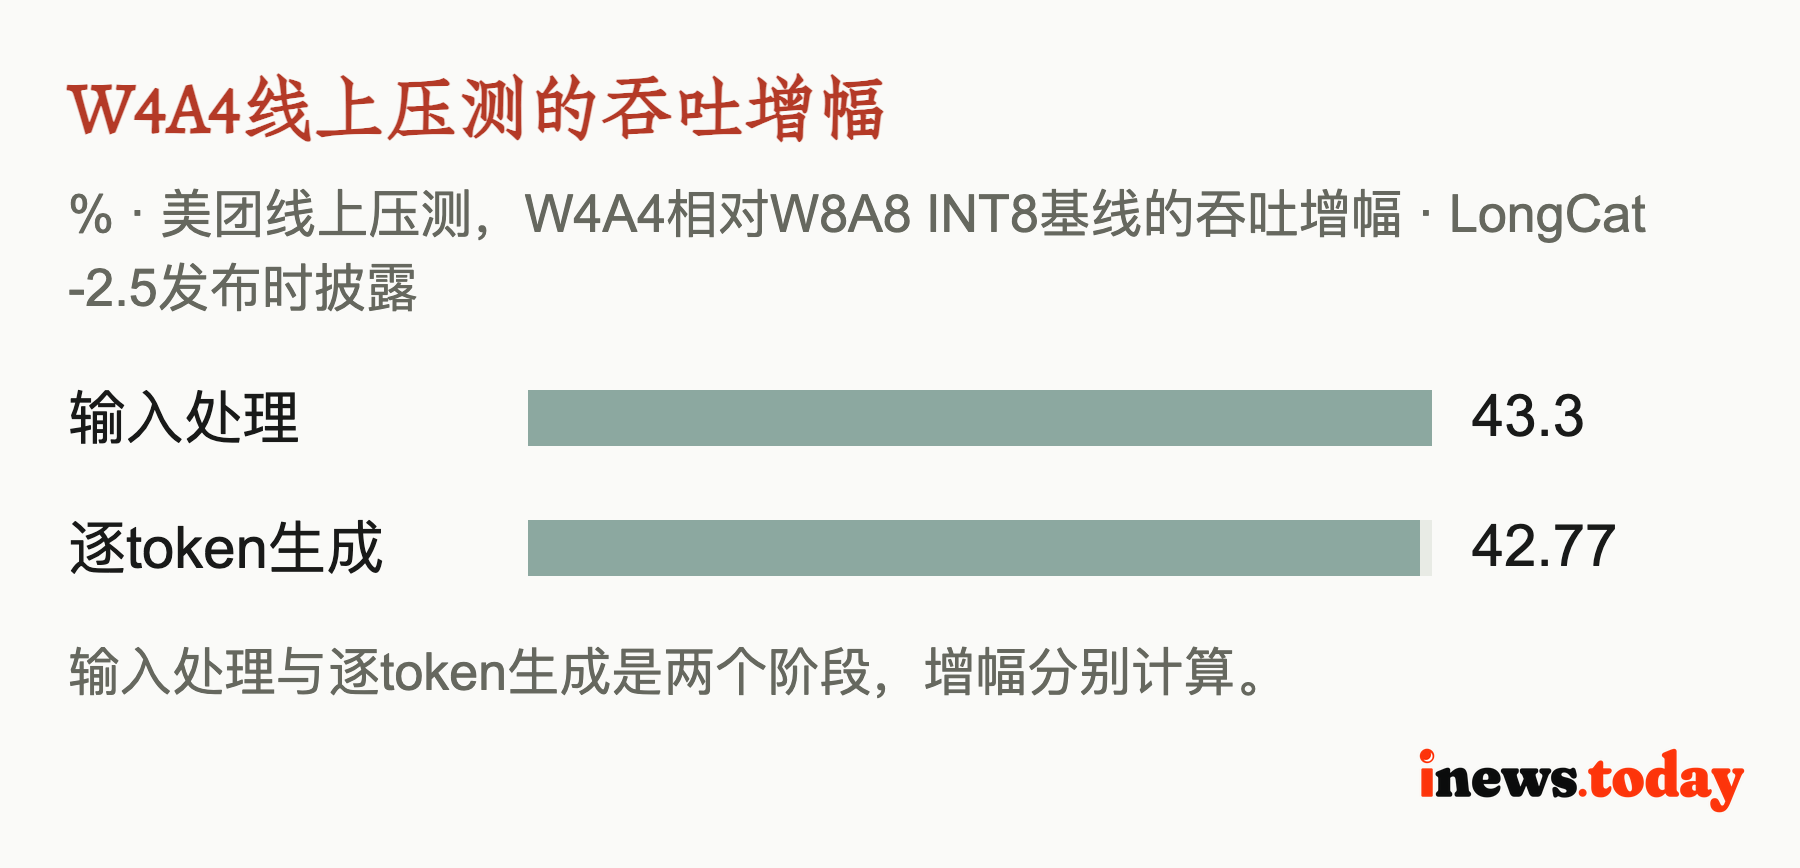
美团披露,线上压测中,W4A4相对W8A8 INT8基线的输入处理吞吐提升43.3%。同一压测中,逐token生成吞吐提升42.77%,基线同为W8A8 INT8。首个token的等待时间降低15.91%,后续每token耗时降低19.72%。模型说明还称,量化后在已评测任务上保持与量化前相当的表现。吞吐和延迟分别关系到集群承接请求的能力与用户等待时间,但这些压测增幅尚不足以直接换算成采购预算或服务利润,实际收益还受请求长度、并发和集群利用率影响。
视觉与长程任务联合训练
原生多模态设计也参与了基础设施优化。LongCat-2.5将原生分辨率视觉特征转换成多层级离散token,由主干模型统一处理视觉与文本。固定的视觉分词器允许提前计算并缓存视觉token,训练时直接装入序列;系统还能根据已知的图像token数量安排数据打包,使不同计算分组承担接近的模态负载。视觉码本与主干联合学习,为理解图像并生成相应代码提供训练基础,也把视觉处理的调度问题纳入了统一序列管理。
长程任务的训练则围绕可验证的工程结果组织。美团从公开代码仓库及内部场景生成任务、交互环境和测试用例,把真实智能体的失败轨迹转成可复现训练任务,并通过测试筛查修复是否有效。为限制模型利用环境漏洞获取奖励,团队在训练环境中断网、清除代码历史和文件缓存,同时惩罚重复思考与重复工具调用。训练系统还对齐训练、输入处理和生成阶段的token概率计算。美团称,这套数值一致性方案已在实验和生产任务中默认启用,为长程强化学习提供稳定的运行基础。
部署样例落实到昇腾集群
实际部署已有具体对象。美团公开的优化样例支持昇腾Atlas A2 Pod,采用视觉编码、输入处理与生成分离部署。该样例在194卡Atlas A2集群上加载真实权重,输入处理和生成节点每台使用16卡,视觉编码器独立使用2卡。部署脚本安排八台生成节点、四台输入处理节点,语言部分通过服务接口访问视觉编码器,并在两类推理节点之间传送注意力缓存。这份配置把多模态服务拆成可分别调度的工作负载,也展示了万亿参数模型落地时所需的集群组织方式。
权重开放后,工程交付仍由部署者完成。样例要求各推理节点使用配套的软件及算子版本,并打通视觉编码、编码结果回传和推理缓存传输通道。由这些要求可以推断,本次开源对已有相应昇腾集群和运维能力的机构更有直接价值:企业获得了可复用的量化实现、通信优化与服务拆分方案,可以沿公开步骤验证自己的负载。后续成本改善能否兑现,要落在这些优化是否减少实际业务中的等待、搬运和闲置资源上。
备注与来源 · 16 条
全文 · 16 条
- [1] 美团发布采用中国芯片训练的1.6万亿参数“LongCat-2.5” aitimes.com ·
- [2] 美团开源大规模LongCat-2.0 AI模型 称其基于国产芯片训练 siliconangle.com ·
- [3] 美团LongCat-2.0展示中国无需英伟达即可训练大规模AI模型 the-decoder.com ·
- [4] Anthropic 发布 FlashProve 用于加密 AI 推理证明 unite.ai ·
- [5] 中国的Moonshot、Z.AI和DeepSeek正挑战美国AI实验室 在成本上更胜一筹 fortune.com ·
- [6] 美团龙猫开源 LongCat-2.5:万亿参数模型开放商用与二次训练 ithome.com
- [7] LongCat-2.5 官方模型卡与评测说明 huggingface.co
- [8] LongCat-2.5 官方技术解读:长程强化学习与国产算力优化 meituan.com
- [9] LongCat-2.5 昇腾 Atlas A2 部署实践 github.com
- [10] OpenCode 模型目录、免费额度与数据留存说明 opencode.ai
- [11] LongCat-Next:将多模态信息表示为离散词元 arxiv.org
- [12] IsoExec:消除强化学习训练与推理数值不一致 vllm.ai ·
- [13] OpenAI向联邦政府提供股权 Anthropic摆脱AI模型困境 Meta希望成为新云 siliconangle.com ·
- [14] 前代基线:LongCat-2.0 的五万卡国产集群训练 meituan.com
- [15] 前代开源范围:多精度权重与国产卡推理代码 meituan.com
- [16] LongCat稀疏注意力:流感知、分层与跨层索引 arxiv.org
本文话题由作者精心挑选,多方研究和对比后,编辑审阅发布。引用来源与链接统一列在文末。相关快讯:/s/747273。