

专栏计算与加速
诺塔让AMD GPU与NPU共用模型,大模型推理性能最高提升30%
诺塔11月4日在AMD首尔活动上披露,通过让Ryzen AI Max+ 395的GPU与NPU分担大模型推理、共用模型,并由AI代理迭代优化,多款模型的推理性能改善约11%至30%。这项端侧验证同时处理了异构运行中的模型重复存储问题。
11月4日,诺塔首席技术官金泰浩在首尔举行的AMD Advancing AI World Tour Seoul 2026活动上,介绍了双方围绕Ryzen AI Max+ 395开展的端侧大模型优化。按照MoneyToday的现场报道,诺塔把处理输入信息的预填充阶段交给NPU,把逐个生成回答token的解码阶段交给GPU,并让两个单元使用同一份模型。参与优化的AI代理负责分析模型、运行软件和底层计算内核,判断瓶颈所在,再反复执行调整。此次公开的是这套软硬件协同方案的测试成果,落点是PC内部的大模型运行。
共用模型释放内存
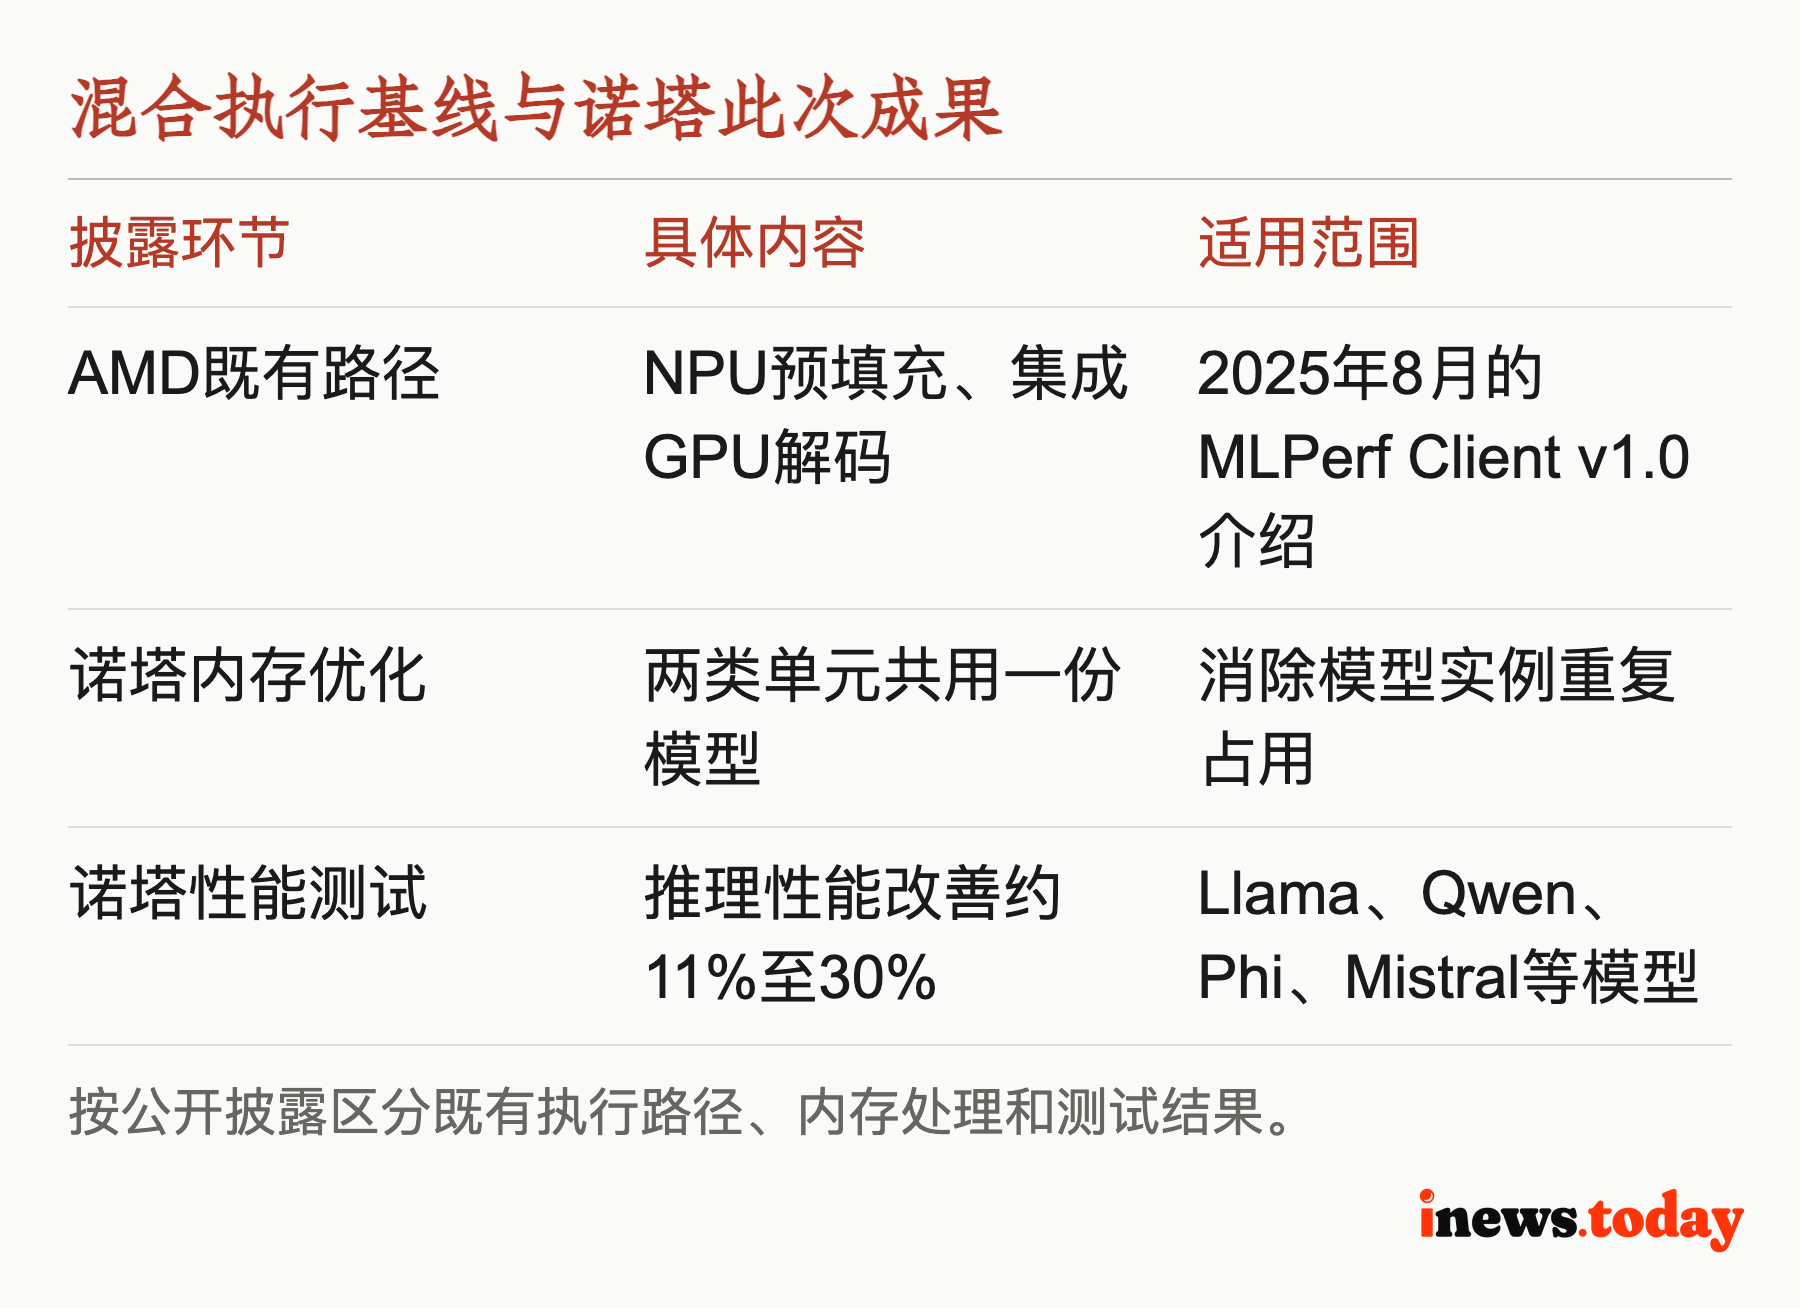
AMD在2025年8月介绍MLPerf Client v1.0时,已经提供NPU处理预填充、集成GPU处理解码的混合路径。诺塔此次进一步让两类单元共用一份模型,解决各自保存模型实例造成的重复占用。MoneyToday报道,诺塔在Llama、Qwen、Phi、Mistral等模型上测得约11%至30%的推理性能改善;The Elec也报道了最高30%的结果。这些是诺塔披露的测试成绩,现场报道没有逐一列出模型版本、量化精度和完整比较基线,因此只能用于说明此次测试的收益范围,无法归并为所有AI PC的统一响应速度增幅。
共用模型之后,内存仍要容纳推理中的临时激活,以及保存历史token状态的KV缓存。HeteroMosaic论文解释,随着输入推进,KV缓存会逐步增长,后续输入片段的注意力计算也随之加重。由此看,诺塔处理的模型重复驻留与长上下文本身的空间需求,是同时存在的两项问题。对选配本地AI机器的团队,这项优化的直接价值是给工作负载腾出内存余量,尚不能据此把整机内存采购需求减半。
代理搜索优化组合
诺塔把优化代理放进流程,是为了处理模型与硬件之间持续变化的适配工作。金泰浩介绍,代理会判断问题来自代码、运行软件还是模型,再选择优化对象并反复执行。诺塔8月发布的NetsPresso技术说明补充了这一过程:用户提供模型、目标设备和性能要求,代理将其转成结构化目标,确定运行时与后端组合,再由超参数优化模块搜索配置。搜索涉及量化算法、权重和激活值的位宽,以及不同层的配置,性能目标还要同时容纳模型大小和输出质量。
自动搜索能否成为企业工具,还取决于结果是否可复现。诺塔称,NetsPresso将代理限制在预先验证过的操作和有效性规则内,防止它尝试不受支持的硬件组合,或把遗漏模型运算的“静默失败”当作成功。搜索算法则利用前一次试验结果,选择下一组有希望的配置。这使代理的职责具体到组织试验、执行和反馈;性能提升仍须经过目标设备上的运行验证,不能由代理自行宣布完成。
AMD的部署文档也显示了这类交付的工程成本。Ryzen AI Software 1.8.0要求先量化模型,再导出并执行混合模式所需的后处理;文档给出的量化耗时是在配备GPU的Linux机器上约30至60分钟。该流程支持已有受支持模型的微调版本,新增架构或算子形状仍需要专门适配。代理可以组织配置搜索,部署团队仍要承担模型准备和运行验证工作。模型支持范围,因而会直接影响优化方案能够接下哪些适配任务。
调度收益受平台约束
把工作分给GPU和NPU,还需要处理两者协作时的系统行为。HeteroMosaic研究将其描述为调度问题:运行时需要协调任务依赖、统一内存争用、动态电压与频率调整,以及NPU自身的执行行为。研究团队把同一条提示词拆成保持依赖关系的微批,利用KV缓存保存此前输入的信息,再调整各阶段的设备分配和完成时间。这给诺塔案例提供了一条具体解释:软件需要安排关键阶段何时完成,两个计算单元被调用只是其中一步。
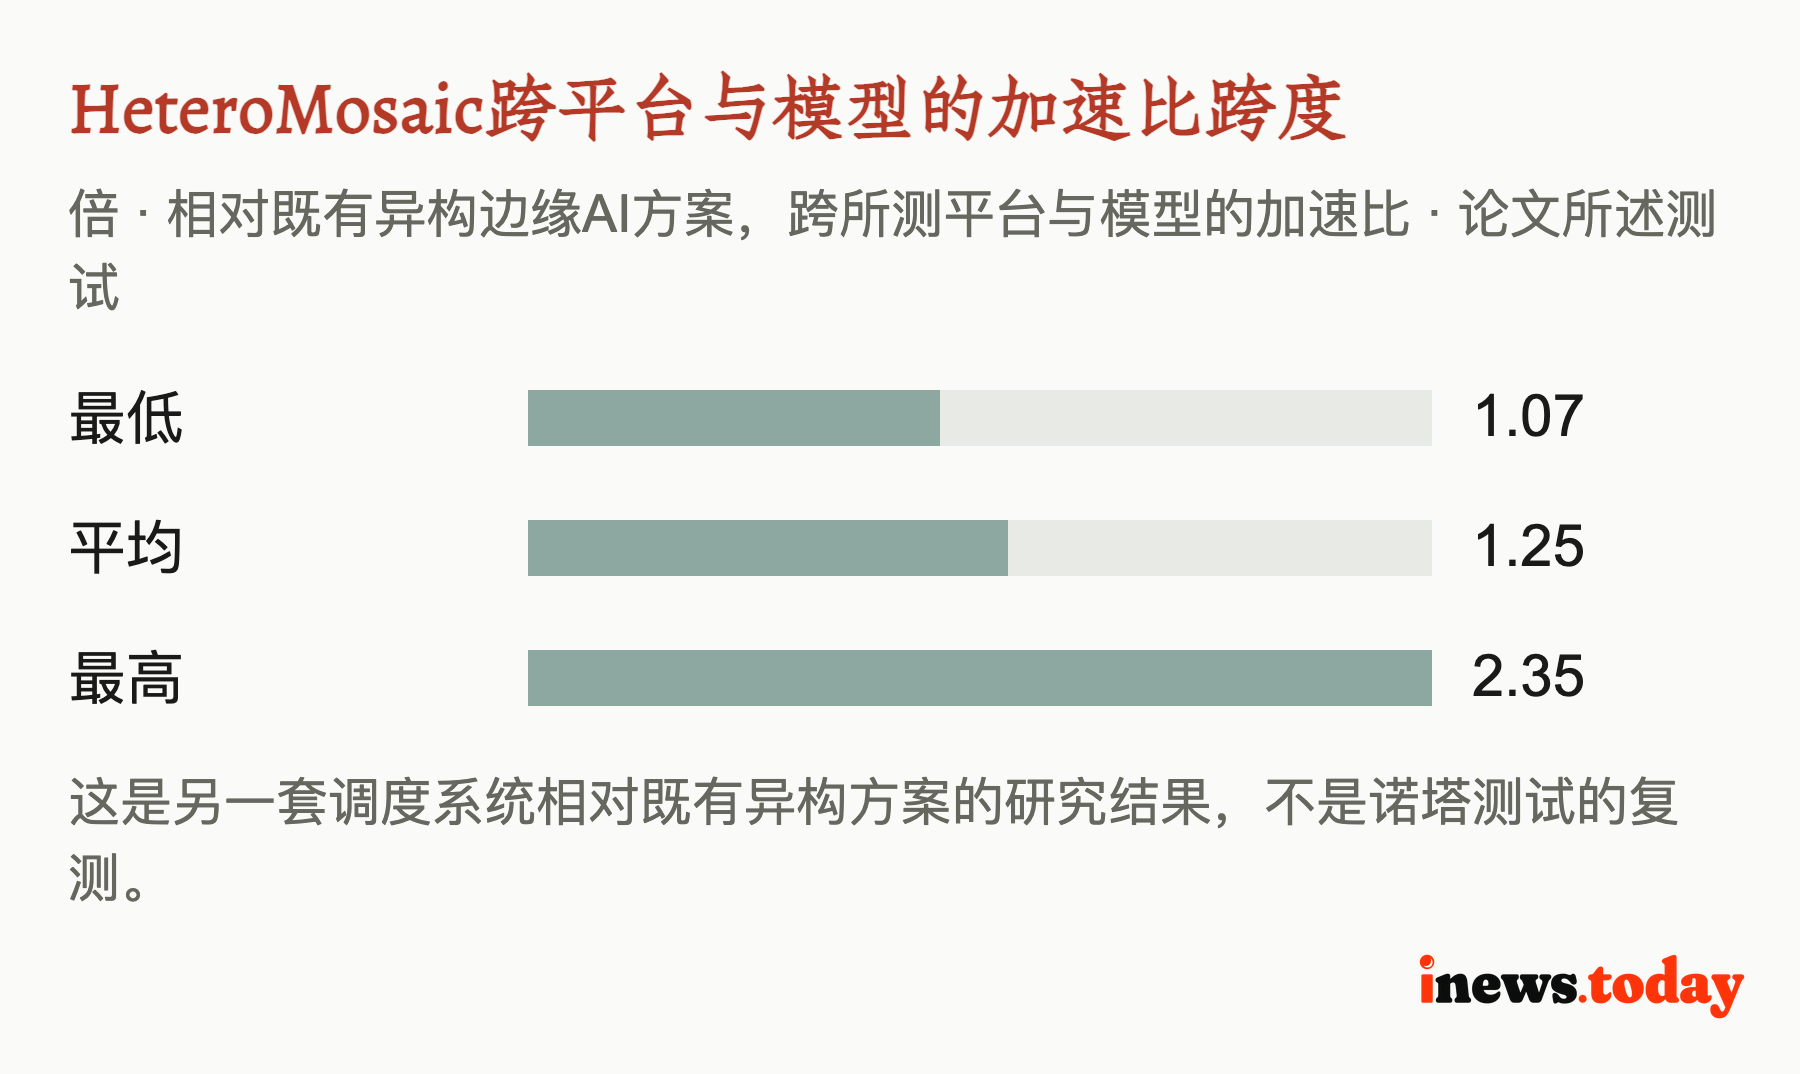
这项由伊利诺伊大学厄巴纳—香槟分校与AMD研究团队开展的工作,覆盖NPU较强、能力均衡和集成GPU较强的AMD平台。研究团队报告,相对既有异构边缘AI方案,跨所测平台与模型的加速比平均为1.25倍,最低1.07倍,最高2.35倍。这是另一套系统的结果,并非诺塔成绩的复测,但其跨度说明,平台资源配比和模型执行特征会实质改变异构调度的收益。最高值适合说明技术潜力,具体部署仍要依据目标组合的测试结果。
诺塔计划把与AMD的合作扩展到企业内部服务器、云和物理AI。就此次PC成果而言,可以推断,其交付价值将取决于共享模型和优化流程能否随模型更新继续工作。AMD文档已经给出一个实际边界:当新架构超出混合流程的支持范围,新增算子的适配仍须回到工程环节。把这部分工作纳入可重复执行的优化流程,才是诺塔从本次性能验证走向持续交付需要完成的任务。
备注与来源 · 14 条
全文 · 14 条
- [1] AMD称Ryzen AI在CPU性能、电池续航和价格上优于RTX Spark thelec.net ·
- [2] 华擎工业AI Box-A395评测:将Strix Halo带入工作场景 servethehome.com ·
- [3] 诺塔CTO:同时利用GPU和NPU,在AMD芯片上将AI推理性能最多改善30% mt.co.kr ·
- [4] AMD披露Ryzen AI处理器的MLPerf Client v1.0测试与混合推理机制 amd.com ·
- [5] 从半自动到全自动:NetsPresso如何通过智能体优化模型 nota.ai ·
- [6] 诺塔在英特尔AI PC上实现GPU与NPU分离推理 daum.net
- [7] HeteroMosaic:通过异构调度提高边缘大模型推理能效 arxiv.org
- [8] MLPerf Client基准:客户端AI性能指标与验证规则 mlcommons.org ·
- [9] GMKtec EVO-X3迷你PC评测:128GB AMD本地AI盒子 servethehome.com ·
- [10] 华擎Creator Radeon AI Pro R9700评测:AMD风格的工作站推理 servethehome.com ·
- [11] 微软Surface Laptop Ultra 128GB评测 servethehome.com ·
- [12] Ryzen AI Software 1.8:混合推理模型准备与内存优化 amd.com
- [13] AMD Ryzen AI Max+ 395官方规格 amd.com
- [14] 诺塔加入AMD机器人合作伙伴网络 nota.ai ·
本文话题由作者精心挑选,多方研究和对比后,编辑审阅发布。引用来源与链接统一列在文末。相关快讯:/s/732854。