

专栏计算与加速
NVIDIA宣称Vera兼顾智能体速度与密度,客户测试指向高并发
NVIDIA在11月5日更新中宣称,Vera CPU可兼顾智能体执行速度与单位功耗容量。Modal、DeepInfra等服务商的测试为高负载表现提供了具体证据,但测试分别隔离了网络、模型生成等环节,商业收益还取决于软件迁移、隔离开销和部署方式。
11月5日,NVIDIA发布Vera CPU的智能体性能更新,将重点放在同一台服务器如何承受更多任务,同时让每个任务及时完成。公司以100兆瓦数据中心作为比较场景,主张运营商在电力上限内同时衡量执行速度和可承载数量,并援引早期合作伙伴的测试支持这一定位。此次披露的核心是平台性能主张及生产式测试,还不是一座同等规模数据中心的实际运行记录。对提供代码执行、检索和工具调用的服务商,这些指标关系到服务器可以装下多少付费工作负载。
两组倍数的比较基准
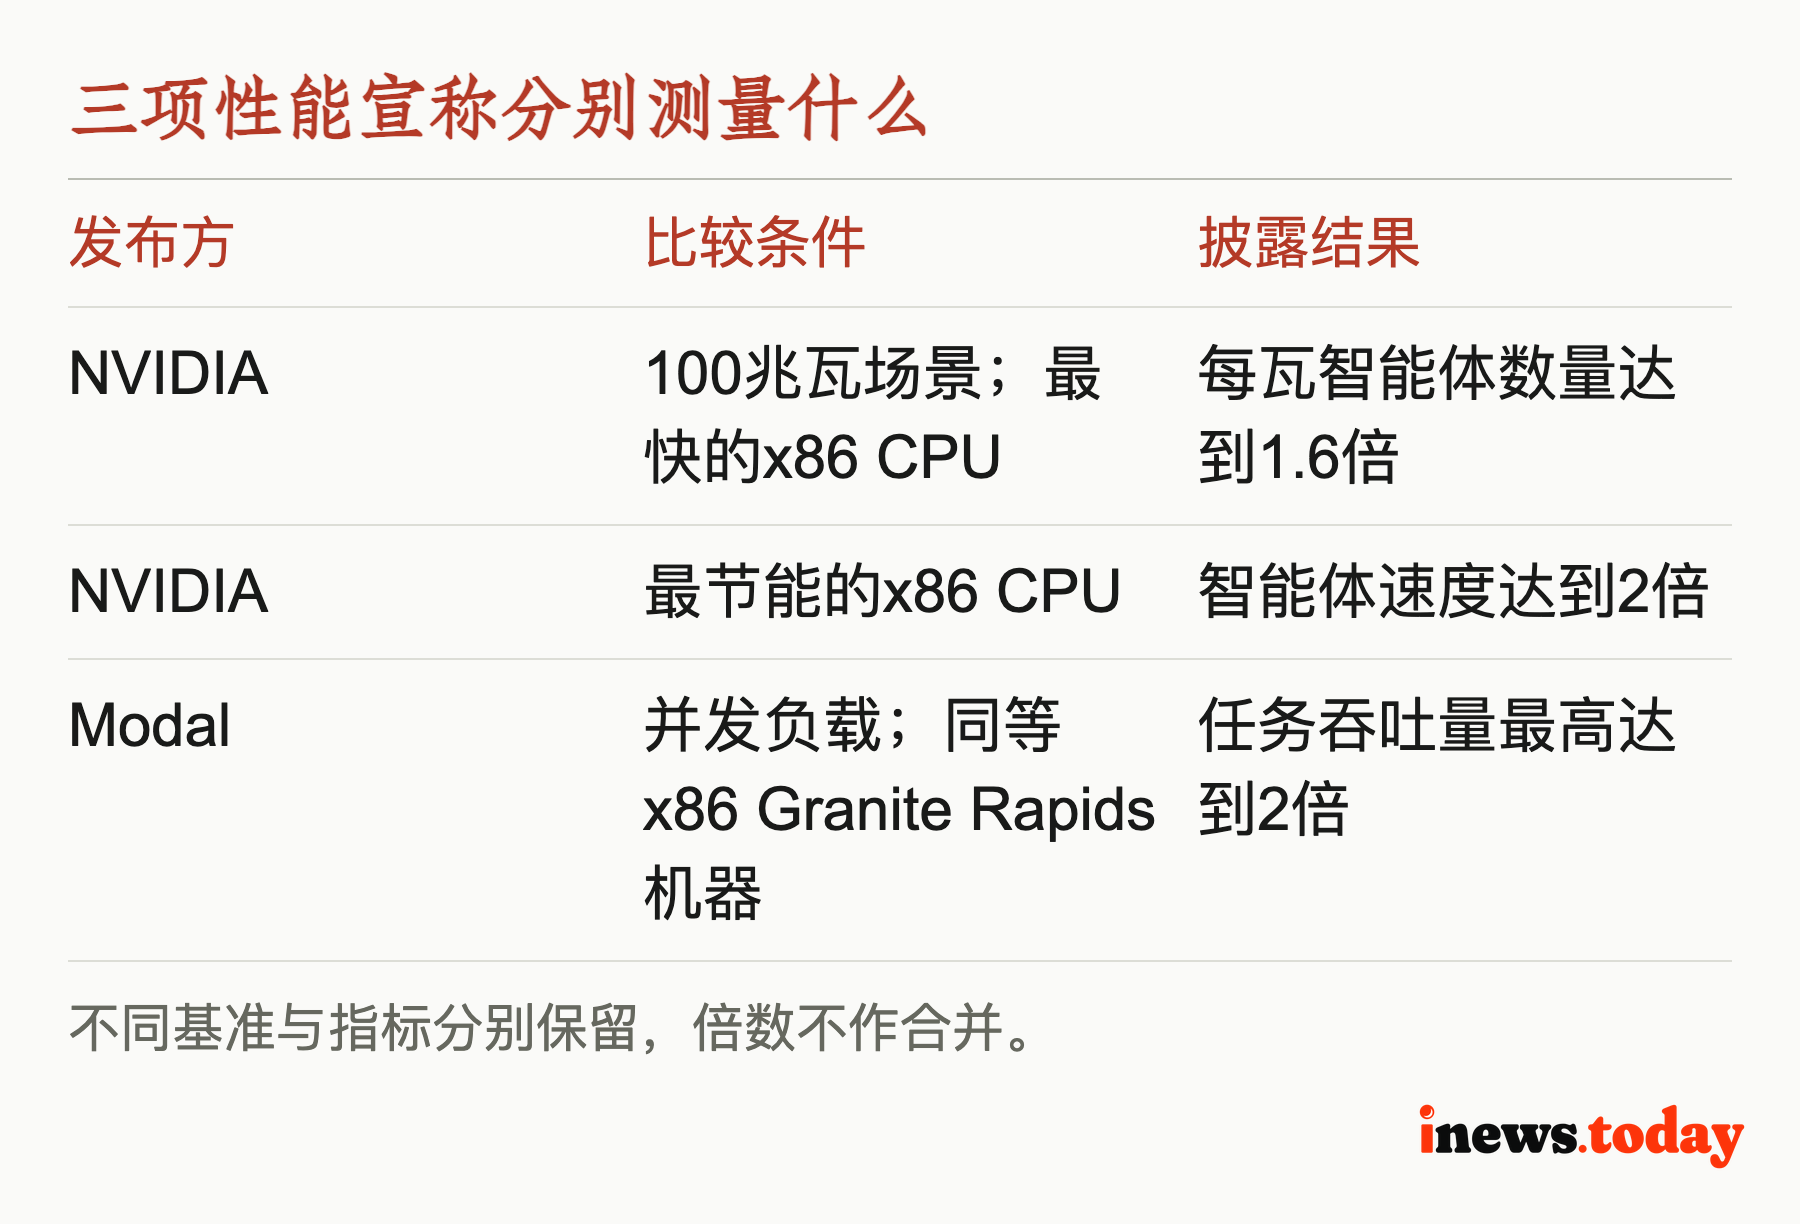
NVIDIA称,在100兆瓦数据中心比较中,Vera相对最快的x86 CPU,每瓦可支持的智能体数量达到1.6倍。相对最节能的x86 CPU,公司称Vera的智能体速度达到2倍。上述两个倍数不能合并为同一种配置同时兑现的收益,因为比较对象和衡量指标都不同,数据中心场景也不足以还原全部设备与功耗假设。Modal则报告,Vera在并发负载测试中,相对同等x86 Granite Rapids机器的任务吞吐量最高达到2倍。这项服务商自测支持的是特定沙箱任务下的容量优势,不能直接替代NVIDIA的每瓦性能测算。
Modal的测试边界可以从公开代码追溯。它选取50个Terminal-Bench参考解法及验证程序,移除网络调用,提前构建兼容Arm的镜像,并在预热容器内反复执行;只有通过验证的运行才计入完成量。这样测到的是编译、文件搜索、git操作等本地执行能力,不包含模型思考、下载依赖和每轮新建容器的耗时。对采购者而言,这是一项可复查的CPU执行测试,但还不是用户从提交请求到拿到结果的完整服务计时。
DeepInfra则回放生产智能体已捕获的流量,按固定节奏注入编排、沙箱进程启动和内存操作,运行期间不生成实时模型token。它给每款芯片划定20个物理核心、每核一个线程,并限定在单一NUMA节点,避免跨内存域调度干扰。在安全microVM测试中,以99百分位响应不超过6秒、零错误为服务门槛,Vera维持了256个并发智能体。这个结果把容量放在明确的服务质量约束内,比单列可以启动多少环境更接近运营商的交付责任。
密度收益要算整机账
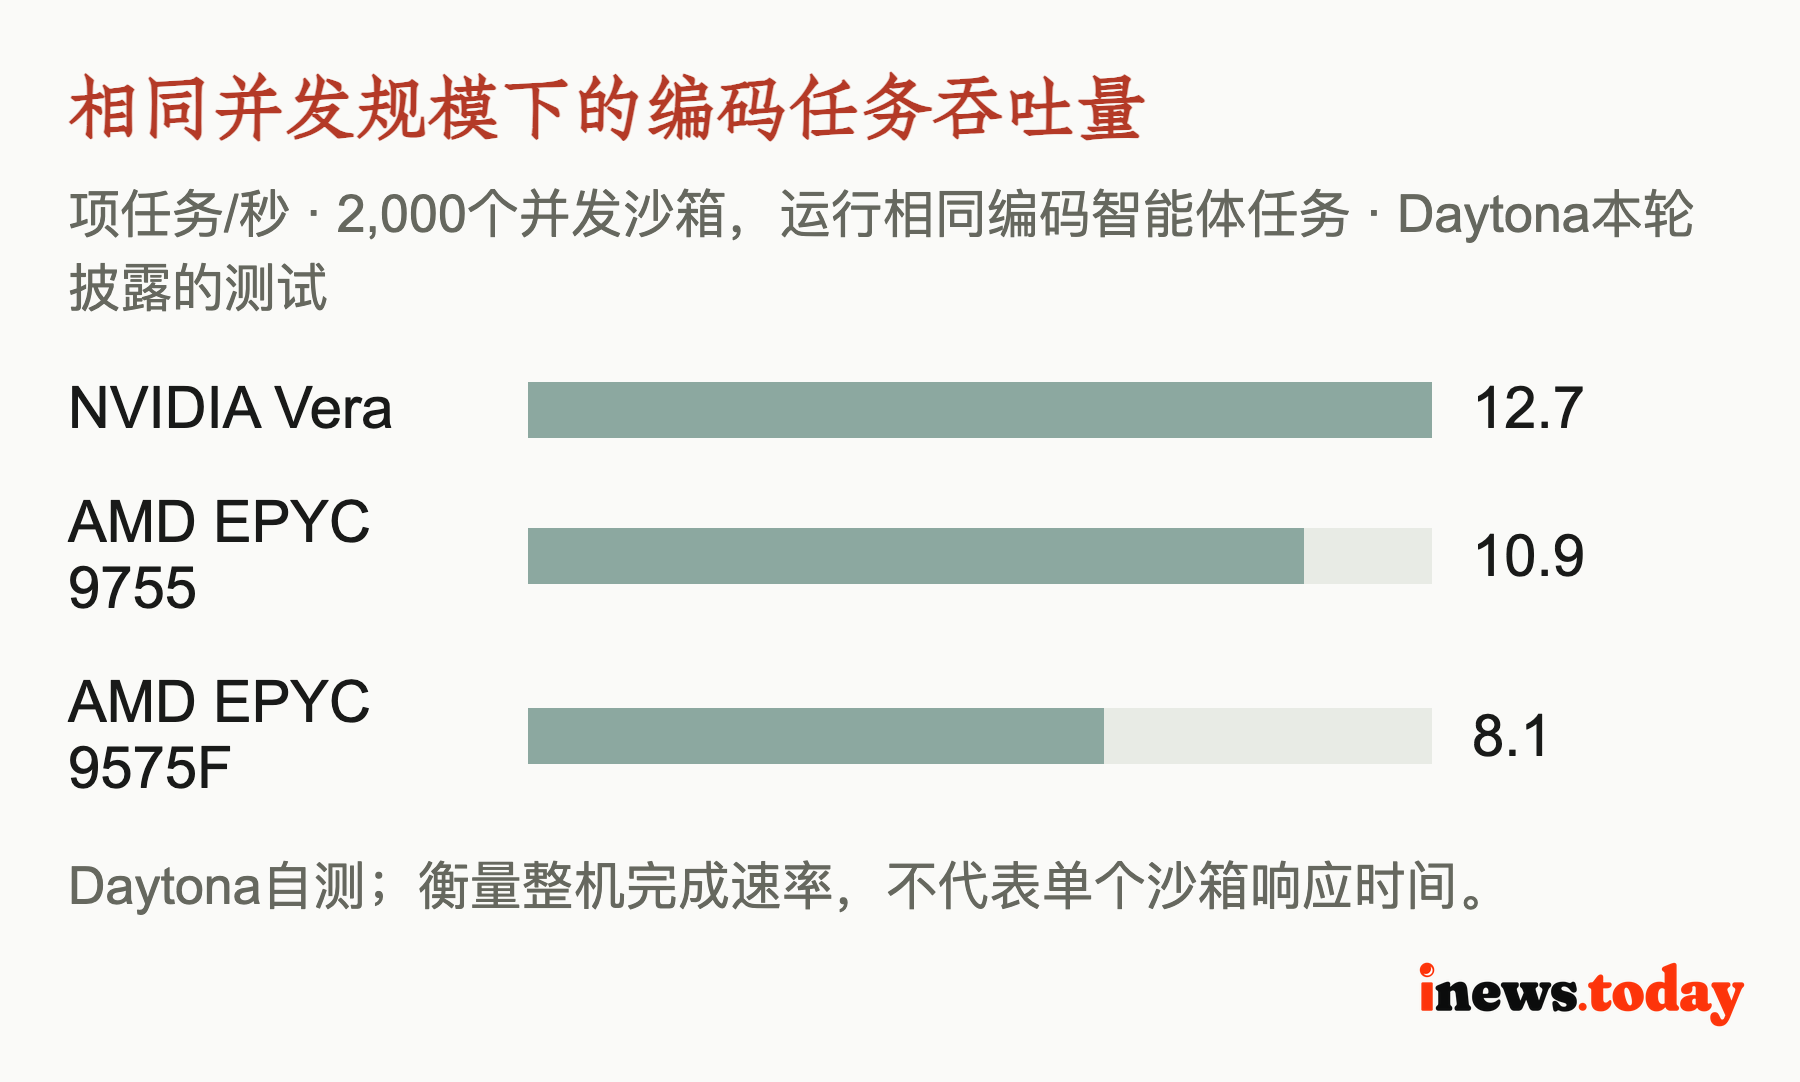
Daytona把测试推进到密集沙箱运行阶段。在2,000个并发沙箱运行相同编码智能体任务时,NVIDIA Vera完成12.7项任务/秒,AMD EPYC 9755完成10.9项任务/秒,AMD EPYC 9575F完成8.1项任务/秒。Vera在整个并发扫描中的峰值为13.3项任务/秒。这里有价值的变化是:环境继续增加后,整机仍能保持接近峰值的产出。不过,总吞吐稳定只说明机器持续完成工作,不能单凭这个指标判断每个沙箱需要等待多久。
启动速度也会反复进入成本账。Daytona称,平台日常创建数百万个沙箱,沙箱寿命中位数不足五分钟;其测试中,Vera让1,000个相同镜像的沙箱全部就绪用了10.8秒。环境不断销毁重建,启动耗时便会持续占用交付窗口。对于吞吐带来的节约,本文的判断是:只有单机价格、功耗和软件成本可控,减少所需服务器才会转成实际成本下降;完成量本身还不足以推出电费或总成本降幅。
软件与供给决定落地
Vera采用88个自研Arm兼容Olympus核心,提供176个硬件线程,内存带宽最高为1.2 TB/s。高带宽的意义在于,多批任务同时读取代码和数据时,内存供给不应过早成为所有核心共同等待的瓶颈;线程资源划分则试图保持拥挤时的执行进度。架构解释了设计方向,但不能仅凭带宽规格,就把各家测试中的全部收益归因于内存系统,软件配置和任务形态同样参与决定结果。
硬件容量还要经过软件层才能交给客户。Modal表示,支持Arm需要改造基础设施和镜像构建系统。DeepInfra扩展到整插槽测试后,首先碰到的限制来自microVM启动路径,而非CPU极限。隔离环境又是运行不可信、多租户代码的必要条件,不能为了保住芯片成绩就把这层成本从生产配置中拿掉。对沙箱平台,镜像适配、虚拟化和调度工程因此直接影响性能优势能兑现多少。
Oracle的公告已把Vera列为可独立于GPU部署的CPU平台,提供裸金属和可调整规格的虚拟机,初期计划在旗下区域提供150,000颗CPU。OpenAI计算业务技术负责人Uday Ruddarraju在公告中称,正把OCI上的Vera引入生产,用于智能体沙箱。这让Vera的商业路径落到了可单独采购的执行容量上,服务商可以按工具调用和沙箱需求扩容,不必把每次CPU扩容都绑在GPU服务器采购上。
Oracle还指出,加快CPU步骤有助于减少GPU等待和上下文缓存压力。由此推论,Vera更容易兑现回报的业务,是CPU执行持续拖慢模型循环、并发负载又足够高的智能体服务。若主要时间花在网络或外部工具上,CPU释放的余量就不会等比例变成用户节省的时间。此次测试最有分量的贡献,是把采购依据推进到带着实际隔离配置和服务门槛,衡量服务器最终完成多少工作。
备注与来源 · 16 条
全文 · 16 条
- [1] NVIDIA Vera CPU 性能宣称瞄准速度与规模的权衡 remio.ai ·
- [2] Vera宣称同时实现最高吞吐量与最快智能体速度 nvidia.com ·
- [3] DeepInfra实测Vera:智能体编排、并发容量与隔离开销 deepinfra.com
- [4] Modal称Vera使其沙箱任务吞吐量最高翻倍 modal.com ·
- [5] 当2000个智能体共享一颗CPU daytona.io
- [6] ClickHouse实测Vera:数据库能否充分利用新硬件 clickhouse.com ·
- [7] Oracle宣布Vera CPU计算服务正式可用 oracle.com
- [8] CoreWeave预告Vera CPU服务及更高智能体部署密度 coreweave.com ·
- [9] Modal智能体执行基准的公开代码与方法 github.com
- [10] Phoronix实测Vera单路与双路CPU性能 phoronix.com
- [11] Signal65研究Arm AGI CPU:机架级智能体工作量比较 signal65.com ·
- [12] Supermicro推出NVIDIA Vera CPU机架,一款256 CPU、100%液冷的机架级解决方案,与NVIDIA Vera Rubin平台互补,面向规模化智能体AI prnewswire.com ·
- [13] 英伟达将Vera CPU与AI智能体协同工作以加速芯片设计 siliconangle.com ·
- [14] 英伟达Vera Rubin和Vera CPU现已在Oracle上全面可用 datacenterdynamics.com ·
- [15] CES 2026:Nvidia承诺Vera Rubin将实现五倍AI性能且推理成本降低十倍 the-decoder.com ·
- [16] Meta是AMD第六代EPYC CPU的主要客户,部署数百万颗EPYC芯片,并将采用下一代Instinct MI500及机架级解决方案 wccftech.com ·
本文话题由作者精心挑选,多方研究和对比后,编辑审阅发布。引用来源与链接统一列在文末。相关快讯:/s/648317。