

Anthropic收紧蒸馏防线,月之暗面与DeepSeek争议待厘清
Anthropic在10月12日公布反蒸馏措施,称已压低未经授权获取Claude推理数据的规模。围绕月之暗面与DeepSeek的相关披露,具体指控涉及Claude输出和用户请求转发,尚未提供两家公司利用GPT-6 Astra训练新模型的直接证据。
10月12日,Anthropic发布反蒸馏技术说明,介绍其如何限制Claude推理记录流转、识别提取请求并封禁相关账户。公司称,早期证据显示,这些措施使蒸馏者获取的数据量减少约90%至99%,测量对象是其平台上被提取的推理词元。说明再次提及月之暗面,指称部分发给Kimi的用户请求曾被秘密转交Claude,以收集输出用于蒸馏。这是模型提供商公布的检测结果与指控,尚不能据此确定某个新版本的完整训练来源。
转发请求引出调查
用户数据的去向,是另一条具体线索。TNW在9月22日转述The Information报道,称中国网信部门调查了DeepSeek和月之暗面,关注用户数据是否流向Anthropic;报道当时未有处罚决定,两家公司未公开回应,TNW也说明没有独立核实。TNW的报道和Anthropic这份防御说明均未给出两家公司使用GPT-6 Astra训练新模型的直接证据。
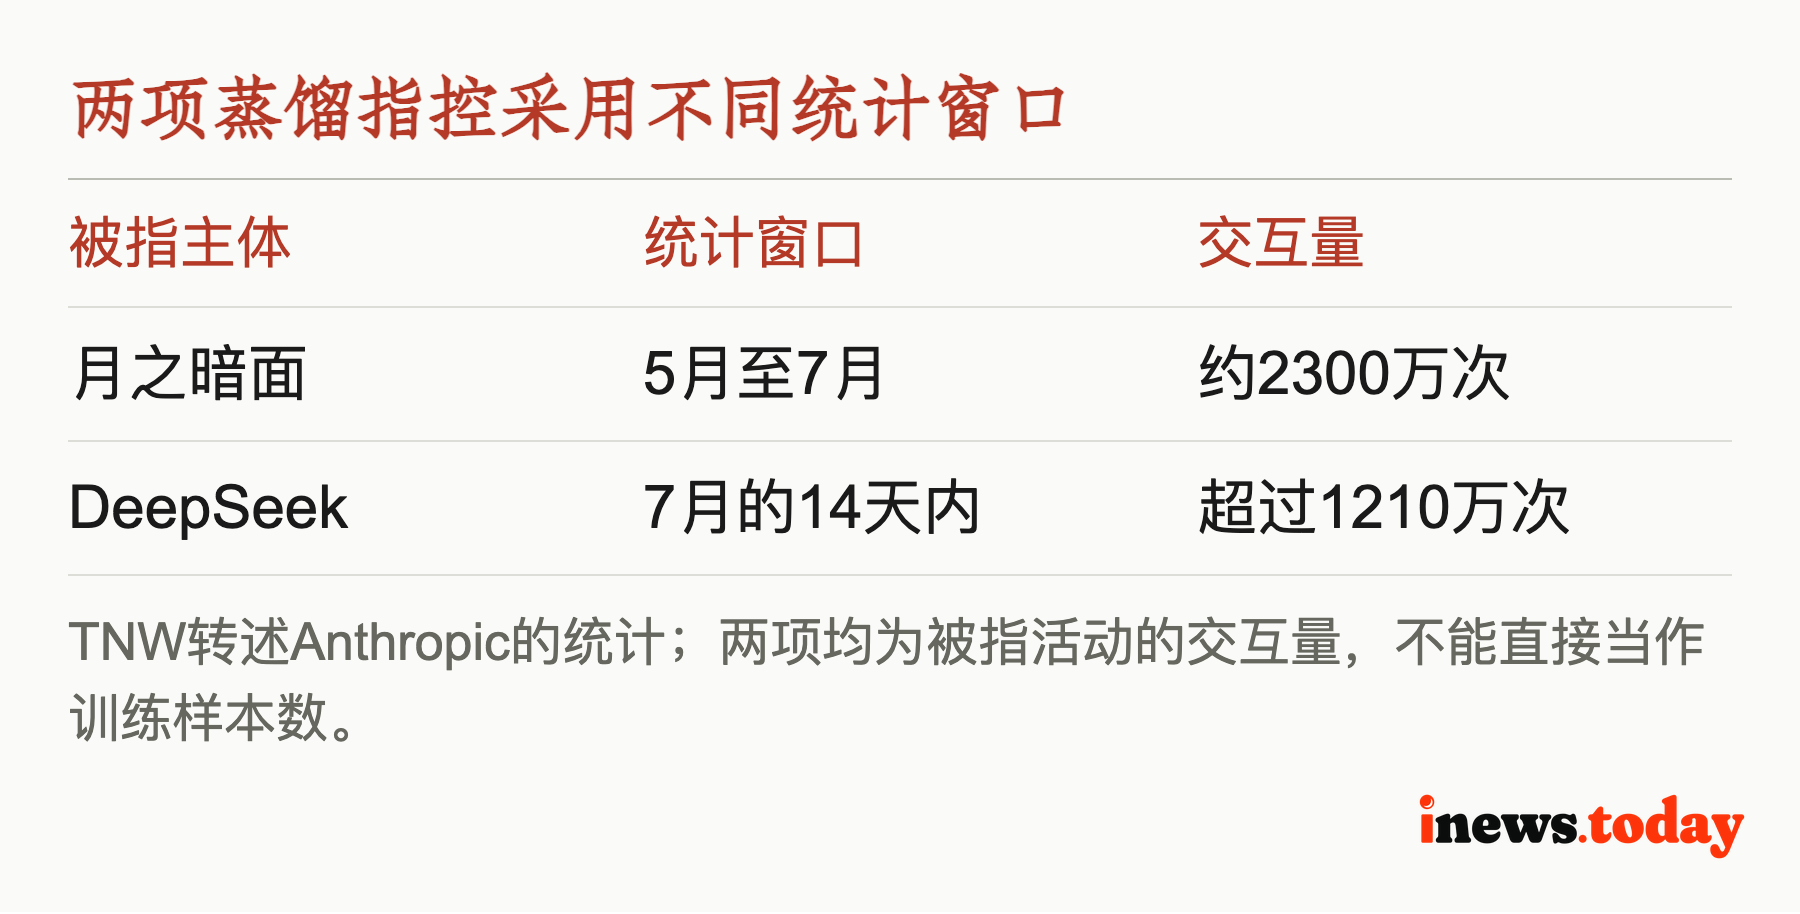
按TNW转述的Anthropic统计,月之暗面的活动在5月至7月涉及约2300万次交互。DeepSeek被指在7月的14天内产生超过1210万次交互。这两项统计的时间窗口不同,不能直接据此判断谁的日常调用规模更大,更不能换算为训练投入。交互总量本身也没有回答哪些输出被保留、进入了哪个检查点,以及对最终能力贡献多少。
推理记录的训练价值
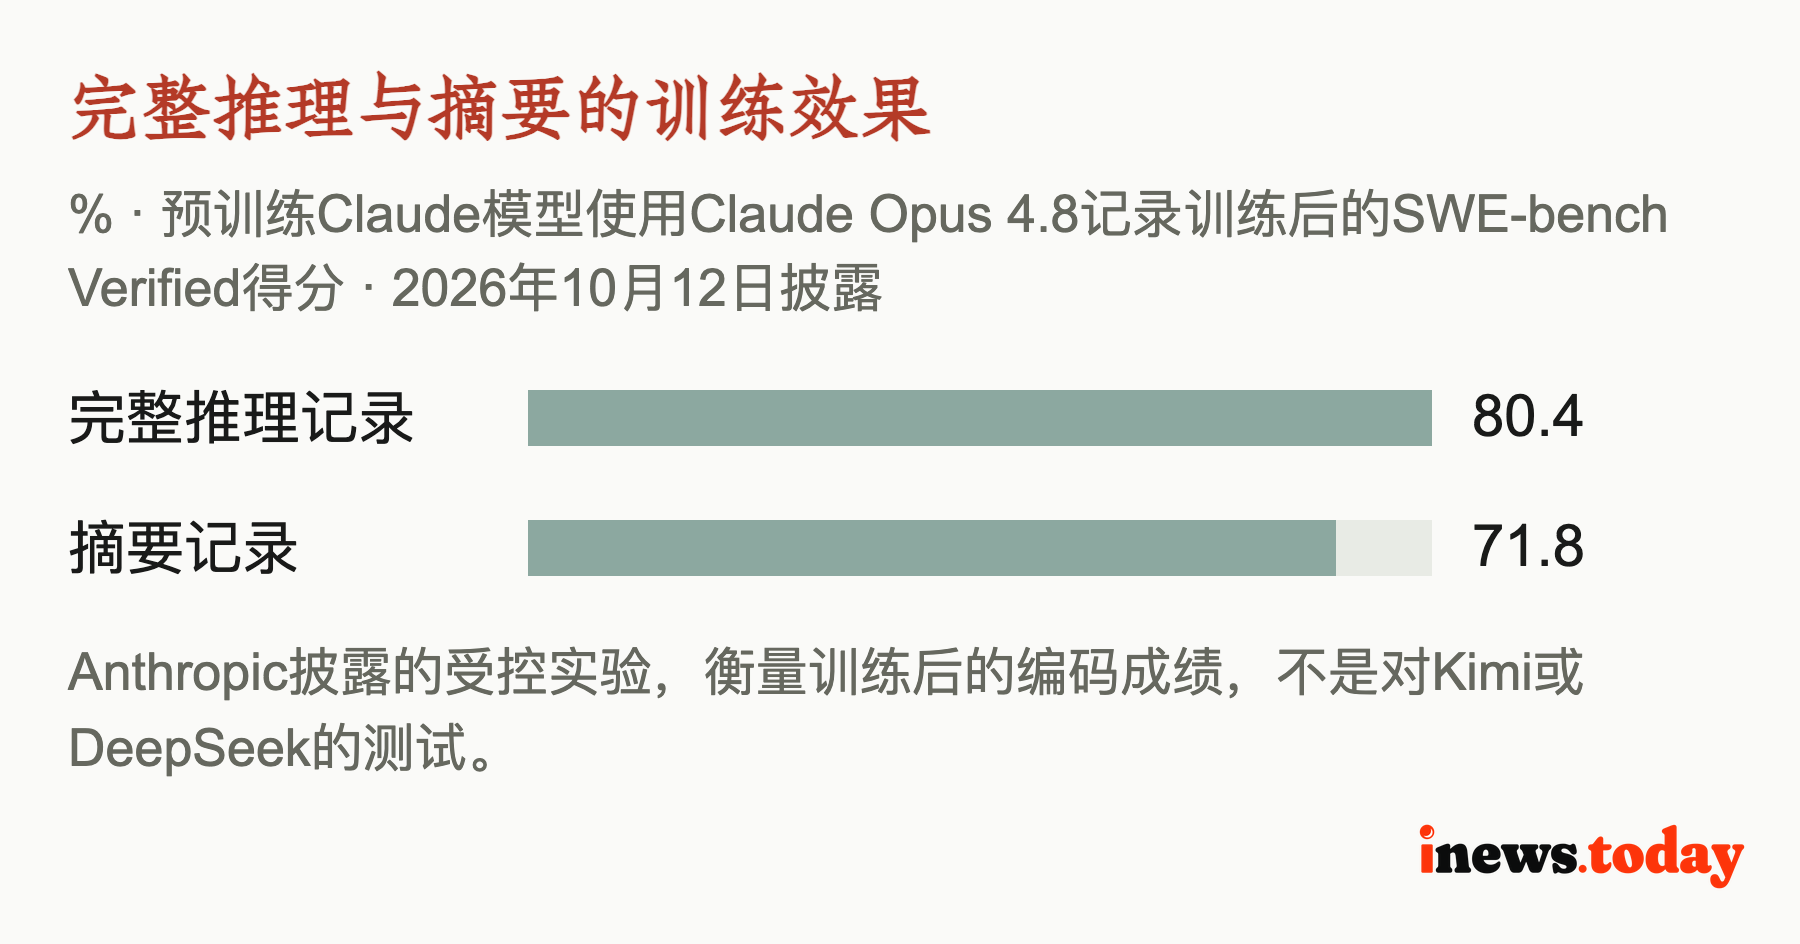
蒸馏是用一个模型生成的数据训练另一个模型;争议还涉及授权方式、账户行为和数据来源。Anthropic将防御重点放在隐藏推理记录上,因为它们展示了得到答案的过程。Anthropic披露,用Claude Opus 4.8的完整推理记录训练预训练Claude模型后,SWE-bench Verified得分为80.4%。Anthropic同一实验只用摘要记录训练时,得分为71.8%。这支持了限制推理访问的技术动机,但实验对象不是Kimi或DeepSeek。
Stolen Thoughts研究团队提供了另一类实验证据:他们从公开的6708条代理执行轨迹中重建了315320个推理区块,涉及Claude、GPT和Gemini。团队还在非基准的真实用户会话中发现704项敏感信息,其中64项只出现在推理区块。研究说明公开日志中的受保护记录也可能泄露信息;它没有证明这些记录被两家公司用于训练,更没有建立GPT-6 Astra与新模型之间的来源链条。
防御成本进入接口
Anthropic目前采用的措施包括限制推理记录跨模型、账户和组织流转,并用两阶段分类器识别提取尝试。对Claude Fable 5.1和Opus 5.5,2026年8月31日及以后创建的API账户不能编辑Claude先前的上下文。公司称,分类器误报率低于0.1%,但也承认部分正常开发者需要修改集成方式,正常请求仍可能被误拦。
收费规则也随之改变。Anthropic称,自9月24日起,对包括蒸馏在内、分类器误报率低于0.1%的特定类别,被安全系统提前拦截的请求也恢复收费。这让反复试探产生直接费用,正常用户一旦被误判,也可能承担账单。公司还称已拒绝数万亿词元的付费流量,但没有披露对应收入金额;这一词元规模不能直接当作损失,也无法据此估算被指企业节省了多少GPU成本。
争议的政策边界同样需要保留归属。中国商务部在9月9日回应美国安全机构公告时,否认相关指控,强调蒸馏是中性的通行技术,并批评地域限制与竞争壁垒。Anthropic则把未经授权提取、虚假账户及安全能力扩散列为问题。双方对行为性质的判断存在分歧;这些立场声明没有替代对具体请求、授权条件和训练数据流向的核实。
新版本的披露边界
产品发布提供了另一组事实。月之暗面于10月23日推出Kimi K3.1 Pro;官方称它是Kimi K3的后训练版本,通过覆盖数百个领域的强化学习训练,并调整长上下文推理、沙箱和任务调度基础设施。模型已上线自有产品与API。不过,发布说明没有交代GPT-6 Astra输出是否进入训练,也没有给出可据以核算训练总成本的算力预算。训练方法说明与训练数据来源,是两项不同的披露。
DeepSeek对V4.1-Flash-1017的说明强调带自反馈的强化学习,用于端到端项目开发;官方仓库已提供权重,采用MIT许可证。这些文件交代了使用与部署条件,却没有披露使用GPT-6 Astra生成训练数据。开放权重允许外界运行和测试模型,但权重本身不会自动还原训练语料、调用账户与数据筛选过程。
10月27日,Artificial Analysis发布智能指数v5,其中60%的评估采用私有测试集或保留答案,Kimi K3.1 Pro得分为46。独立测试可以检验能力,不能识别能力究竟来自哪家模型。月之暗面承诺于2026年11月4日前发布完整权重,这是下一项明确的交付节点。届时外界能够开展部署和复测;要落实到GPT-6 Astra训练指控,还需要涉及该模型的调用证据、数据使用记录或当事方披露。
备注与来源 · 16 条
全文 · 16 条
- [1] Moonshot AI 发布 Kimi K3.1 Pro,在部分基准测试中超越 Opus 5.5 和 GPT Astra 6 officechai.com ·
- [2] Kimi 3.1 Pro 104BA-2.8T:Fable-5.1级开放权重将闭源AI领先优势缩小至1个月……且Pro Highspeed API速度提升2-3倍 latent.space ·
- [3] 加强针对蒸馏攻击的防御 anthropic.com ·
- [4] 从专有大模型API提取推理轨迹 stolen-thoughts.com
- [5] 推出Kimi K3.1 Pro kimi.com
- [6] DeepSeek-V4.1-Flash-1017:实现许愿式编程 deepseek.com
- [7] DeepSeek-V4.1-Flash-1017官方模型仓库 huggingface.co
- [8] Artificial Analysis发布智能指数第五版 artificialanalysis.ai ·
- [9] 商务部回应美方关于中国AI企业蒸馏活动的指控 mofcom.gov.cn
- [10] 据The Information报道,中国调查DeepSeek与月之暗面 thenextweb.com ·
- [11] DeepSeek-R1:通过强化学习激发大模型推理能力 arxiv.org
- [12] 月之暗面推出3万亿参数旗舰模型 Kim K3.1 Pro siliconangle.com ·
- [13] 中国AI模型Kimi K3.1 Pro正逼近Anthropic的Claude Opus 5.5 the-decoder.com ·
- [14] Kimi K3.1 Pro 以更低成本挑战 Claude Opus 5.5 和 GPT-6 Astra propakistani.pk ·
- [15] Anthropic称新防御措施将AI蒸馏攻击中获取的数据削减90%至99% pulse2.com ·
- [16] Kimi K3.1 Pro:Moonshot以具有竞争力的价格推出的新AI模型 basic-tutorials.com ·
本文话题由作者精心挑选,多方研究和对比后,编辑审阅发布。引用来源与链接统一列在文末。相关快讯:/s/628933。