

专栏基础模型
谷歌发布Gemini 4 Carbon登顶综合榜,先向网络防御者开放
Google于10月28日宣布推出Gemini 4 Carbon;独立评测机构Artificial Analysis将其列为新版综合智能指数第一。模型将从本周起向部分网络防御者开放,首发API价格维持每百万输入token 2美元、输出10美元,但尚未进入全面公开供应阶段。
10月28日,Google DeepMind高级副总裁兼Google首席AI架构师Koray Kavukcuoglu公布了Gemini 4 Carbon,重点展示模型在大型代码库中持续排查问题、验证漏洞和编写补丁的能力。Google计划从本周开始,通过Fairwind计划向部分网络防御者提供访问权限,再逐步扩大到其他可信合作伙伴。该计划服务的对象包括政府、医疗机构和电信服务商。Google同时参与美国政府自愿性的模型发布前测试流程,并将根据早期使用反馈调整防护机制,再向开发者、企业和消费者扩大供应。
榜首的测评边界
Artificial Analysis将Carbon列为Intelligence Index v5第一,得分59。在该机构的编程智能体指数中,Carbon以高推理配置配合Antigravity CLI取得59分,Claude Opus 5.5以最高推理配置配合Claude Code取得62分。另一家评测机构Vals AI给出的结果是:Carbon在Vals Index v2.2中得分70.36%,位列29款模型第二,首位Claude Sonnet 5.5为70.85%。综合榜首因此有明确范围,不能替代具体工作负载的选型。
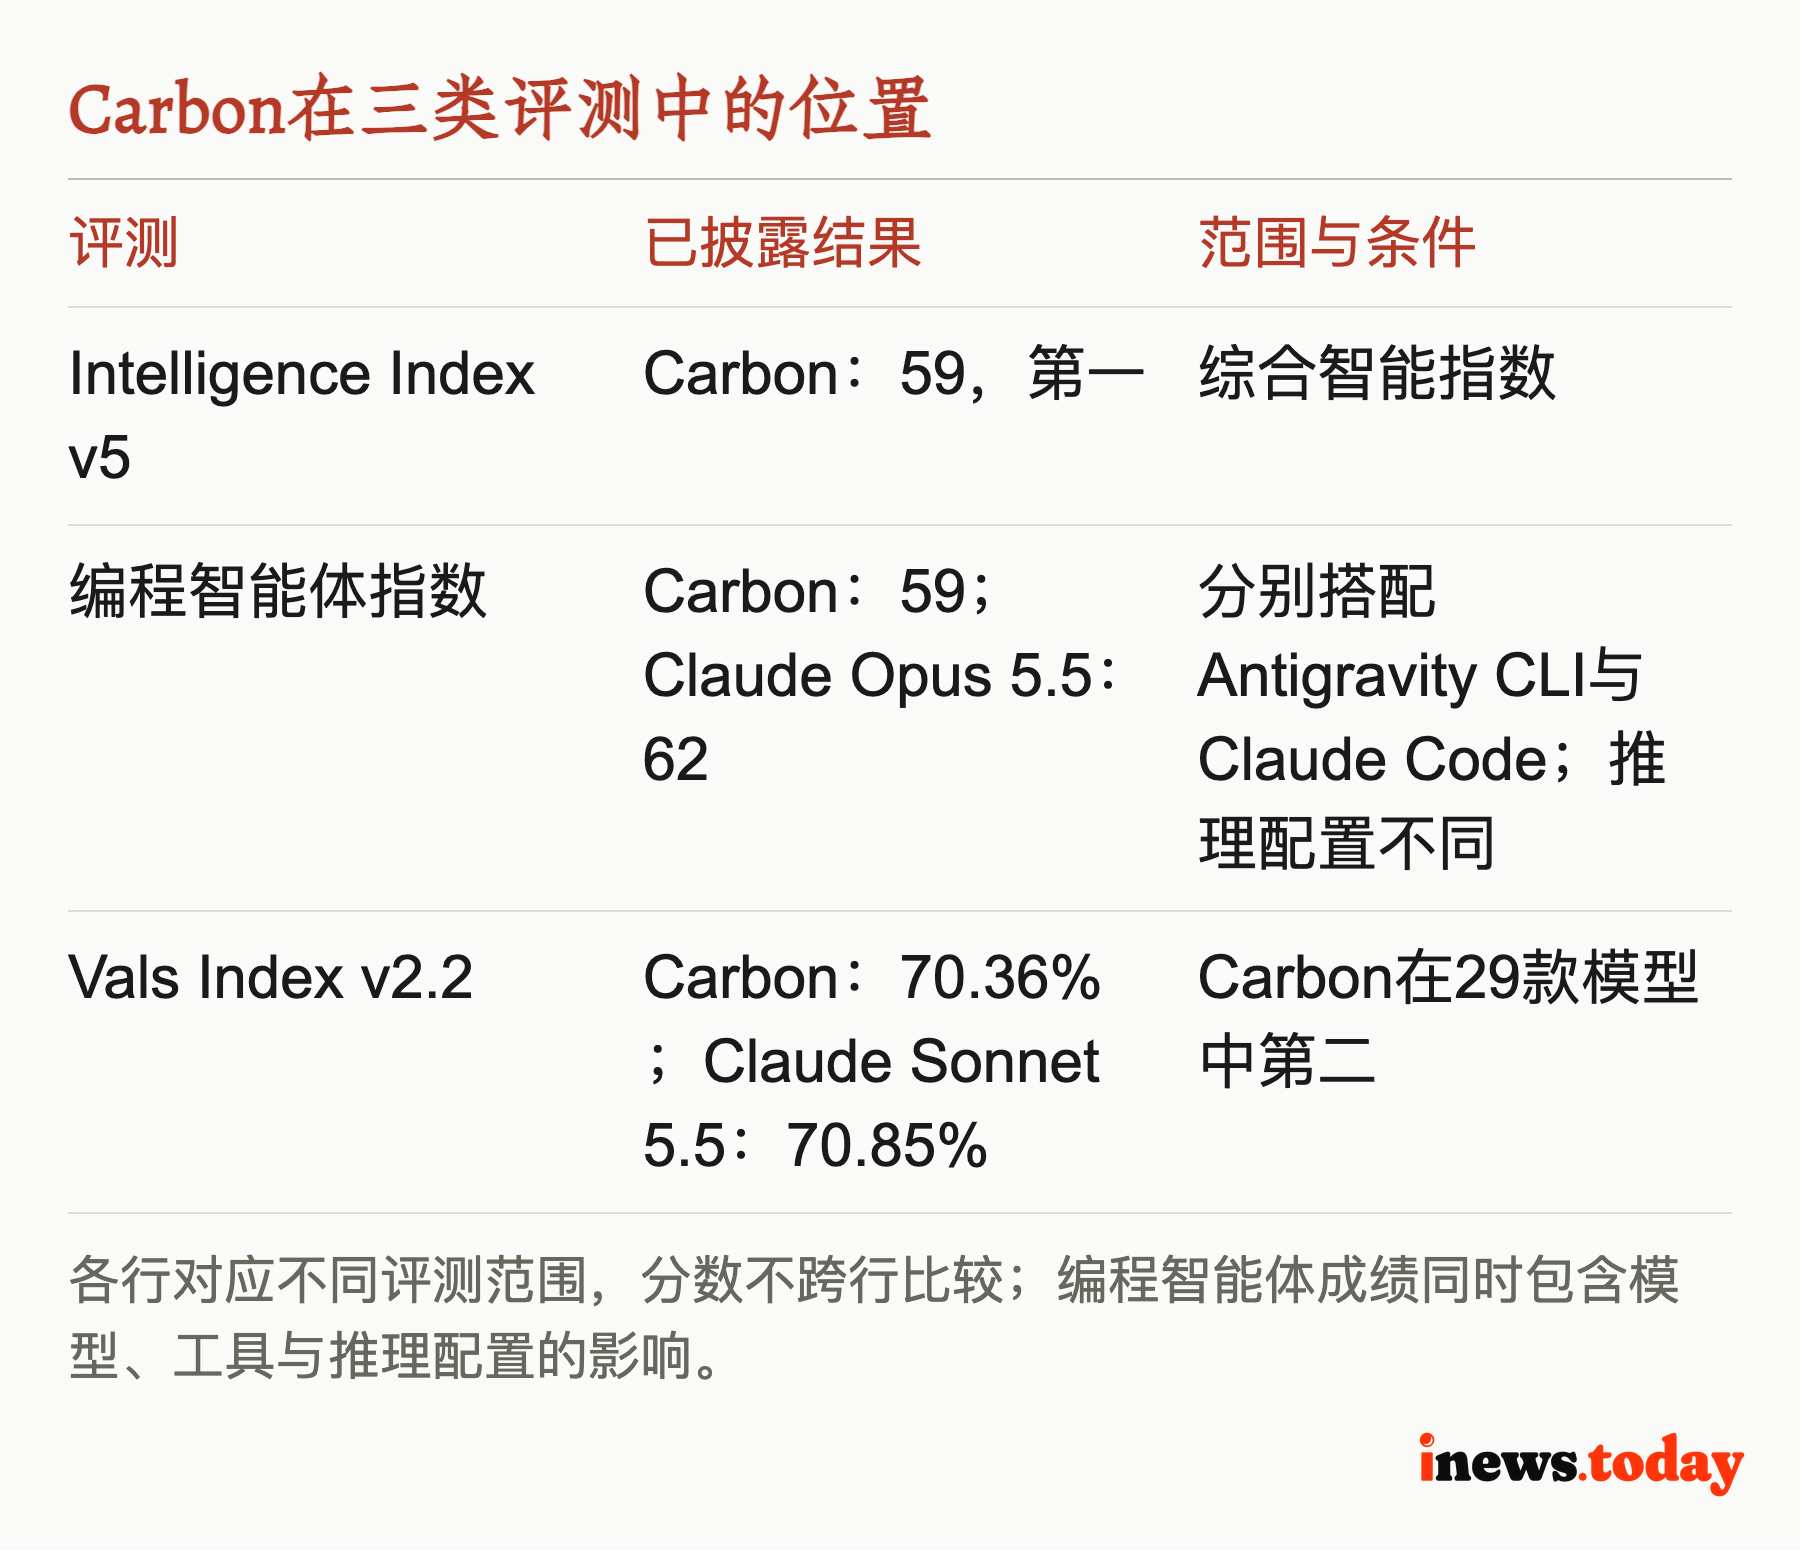
这次综合排名采用的v5包含九项评估,Carbon在其中四项取得第一,覆盖复杂推理、科学任务、知识与自动化工作。Artificial Analysis称,这版指数的大部分评估已使用私有数据集。对采购者而言,这些成绩提供了筛选依据;真正部署时,还要把本企业的代码、工具权限和验收标准放进测试,综合得分本身没有包含这些交付条件。
先向防御者开放
Google披露,Carbon在漏洞发现测试SEC-bench Pro取得88.2%,在检验漏洞利用能力的ExploitGym取得54.8%,在漏洞修补测试CWE-bench取得71.0%。这些任务对应防御工作的不同环节:先找到弱点,再确认风险,最后修改代码。Google注明,这组外部网络安全评估是在关闭防护限制的条件下完成的。它们说明模型具有相应技术能力,但不是普通用户获得访问后每次运行的交付保证。
CWE-bench开发方Collinear AI对其v1的说明,交代了“修好”的验收门槛:模型拿到真实开源仓库,自行审计并修改;补丁必须阻止漏洞利用,同时通过全部既有测试。其120项保留任务在高推理配置下各运行四次,每次限时一小时。以其中的BlurHash解码库为例,补丁既要处理异常字符,也要检查解析后的数值是否造成越界;只修复第一处明显错误,仍可能留下另一条崩溃路径。
Google称,内部团队已经让Carbon连续运行数天,处理大型代码库和底层系统中的复杂缺陷。与这种持续执行配套的是多层安全机制,包括模型训练、实时滥用防御、提示注入抵抗和推理过程监测。提示注入指外部网页、文档等内容夹带指令,诱导智能体偏离用户任务。模型运行时间越长、接触外部内容越多,权限控制和执行监测就越直接地关系到部署方式。
试用价与任务账单
Google公布的Carbon首发价为每百万输入token 2美元、输出token 10美元,缓存输入价格再优惠95%。Artificial Analysis披露的标准价则为输入4美元、输出20美元,并说明其图表按标准价计算。在Artificial Analysis的Intelligence Index评估中,按标准价格计算,Carbon(high)每项任务成本为7.76美元,Claude Opus 5.5(max)为10.04美元,GPT-6 Astra(max)为6.25美元。Carbon在这套评估中的任务费用处于另外两款模型之间,榜首并未同时带来最低账单。
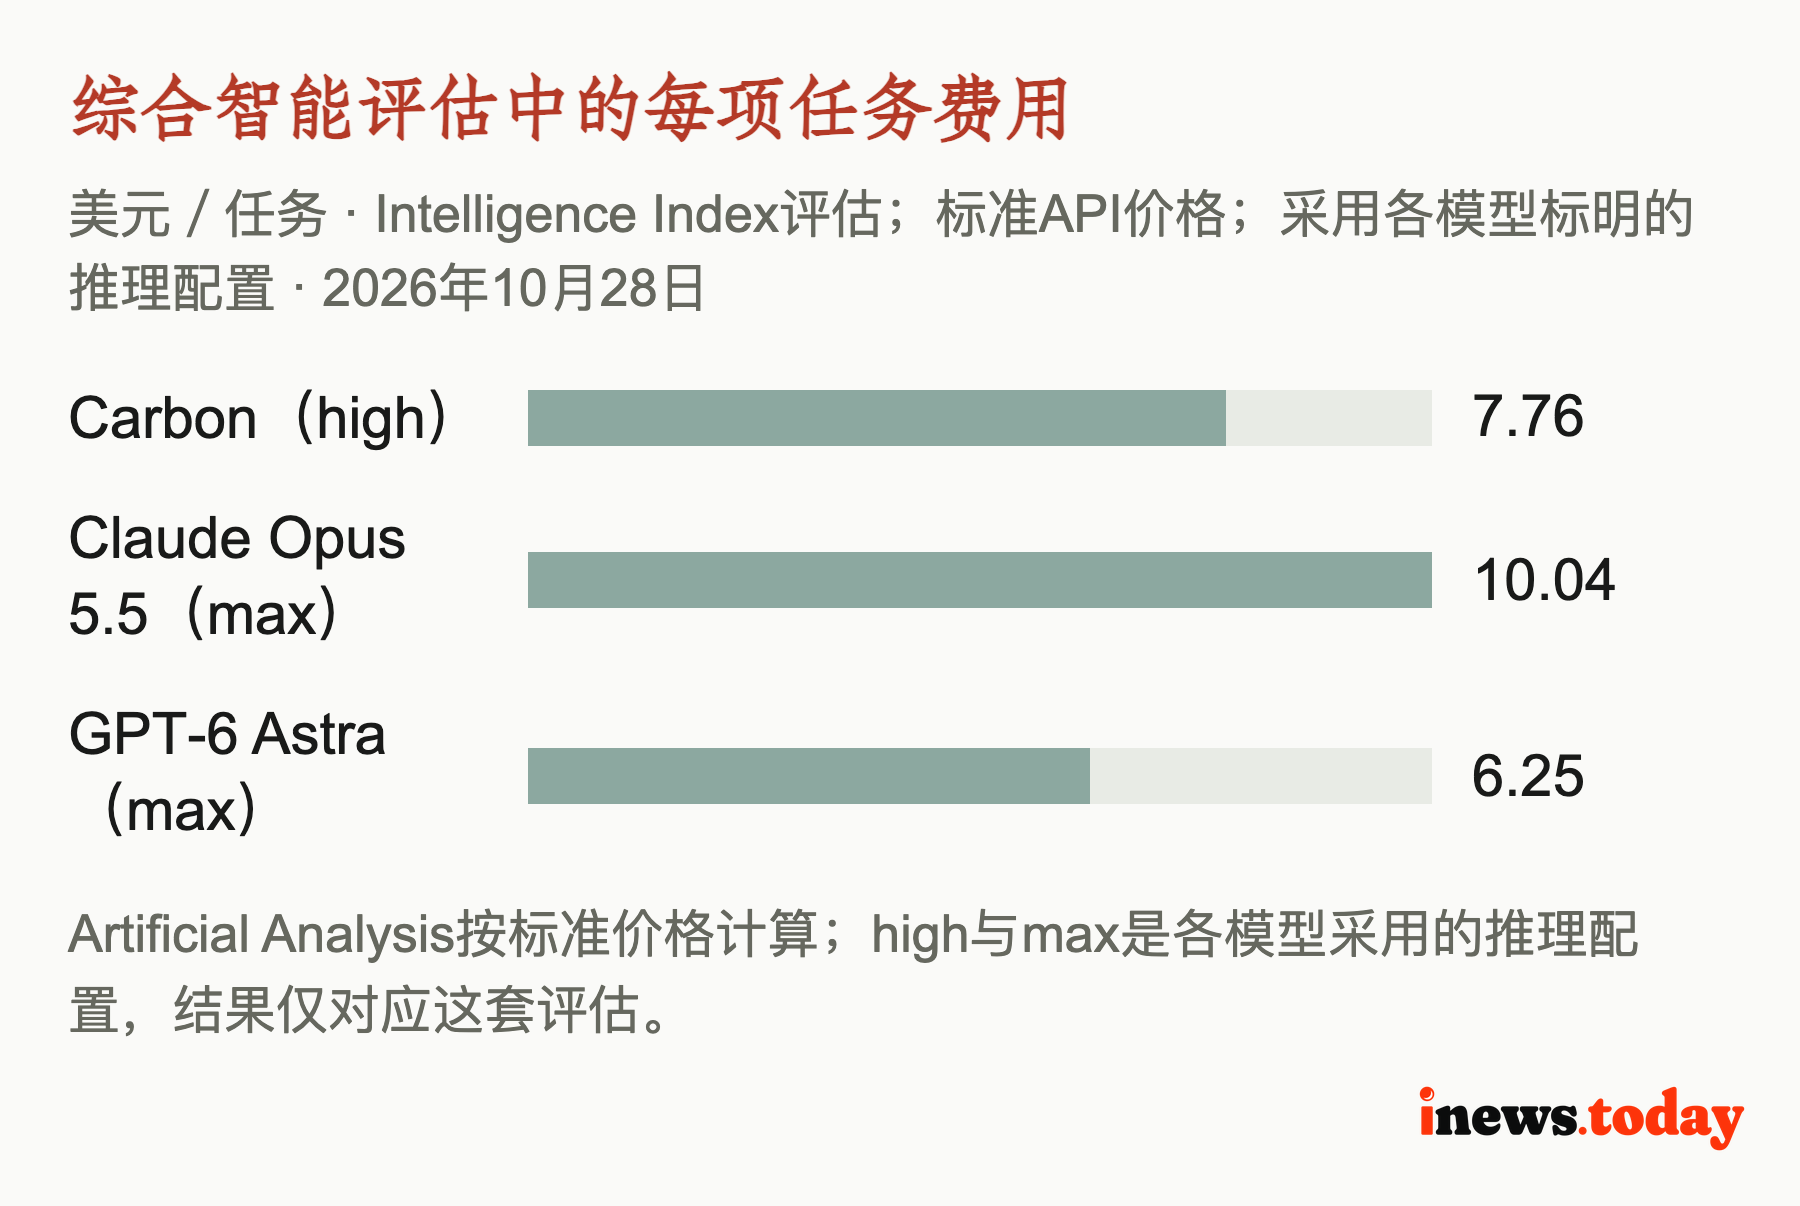
首发优惠尚无确认的结束日期。对需要长期运行智能体的企业,这使预算至少需要分别记录优惠期费用和标准价费用。按token计费也意味着,一次工程任务的支出取决于读取代码、生成修改和反复验证的实际调用量。依据现有披露,尚不能把连续运行数天换算成固定项目报价,更不能据此估算Google的推理利润或数据中心回报。
补丁交付还靠审查
Google Developers Blog在10月13日披露,Argon曾在约20.5万行代码的ADK Python仓库中自主运行11小时,寻找跨文件的性能瓶颈。最终落地的工作包括先筛选会话事件再复制,以及让部分模块按需加载。这个案例展示了长时间自主工作的具体对象:模型需要追踪调用关系、共享状态和测试依赖,维护者则负责判断修改能否进入公共框架。
该项目最终合并的改动涉及22个文件,并配套17个新增测试函数;Google还专门处理了下游测试对模块公共属性的依赖。这为理解Carbon的交付价值提供了一条实际路径:持续推理产生候选修改,测试和维护者审查决定它能否上线。Carbon接下来的已披露节点,是本周向首批网络防御者开放,并通过Fairwind逐步增加可信合作伙伴;Google尚未给出面向开发者、企业和消费者全面开放的日期。
备注与来源 · 16 条
全文 · 16 条
- [1] 谷歌发布 Gemini 4 Argon,面向代码与网络安全的深度推理 AI 模型 etvbharat.com ·
- [2] 谷歌发布旗舰Gemini 4 Carbon模型并升级网络安全功能 siliconangle.com ·
- [3] Gemini 4 Carbon:谷歌下一款前沿模型 blog.google ·
- [4] Gemini 4 Carbon 登顶 Artificial Analysis 智能指数 v5 artificialanalysis.ai ·
- [5] Gemini 4 Carbon 的评测、成本与能力 vals.ai
- [6] Collinear AI 的 CWE-bench 网络安全评测 cwe-bench.com ·
- [7] Fairwind 网络防御计划 deepmind.google
- [8] Gemini 4 Argon 如何连夜优化20万行Python代码库 googleblog.com ·
- [9] 你的AI智能体可能已被攻陷,而你毫不知情 grayswan.ai
- [10] Anthropic 扩大 Glasswing 网络防御计划 anthropic.com ·
- [11] Gemini 4 Argon现已在全球范围内推出,成为谷歌最强大的前沿模型 the-decoder.com ·
- [12] 谷歌发布Gemini 4 Argon AI模型,但用户目前尚无法使用 arstechnica.com ·
- [13] Gemini 4:谷歌推出Argon人工智能模型,瞄准复杂的企业级与网络安全工作流 sundayguardianlive.com ·
- [14] 谷歌发布 Gemini 4 Argon,其迄今最强大的 AI 模型 analyticsinsight.net ·
- [15] Google 发布 Gemini 4 Argon,迄今最强AI模型;CEO Sundar Pichai 表示:我们将让 indiatimes.com ·
- [16] 谷歌发布 Gemini 4 Argon,一款旨在捕捉软件漏洞的 AI 模型 cryptobriefing.com ·
本文话题由作者精心挑选,多方研究和对比后,编辑审阅发布。引用来源与链接统一列在文末。相关快讯:/s/625432。